Workflow ComfyUI — это файл JSON со схемой узлов: загрузчики моделей, промпт, сэмплер и сохранение результата. Чтобы им воспользоваться, скачайте файл и перетащите его в окно ComfyUI: интерфейс сам расставит узлы, а вам останется разложить модели по папкам models. Красный узел значит, что не хватает дополнения, его ставит Manager. Нашим пяти схемам из дополнений нужно одно, ComfyUI-GGUF, оно грузит сжатые модели .gguf. Все пять мы запустили 16 октября 2026 года на своей видеокарте RTX 4070 Super с 12 ГБ. Картинка по тексту во FLUX.2 klein 4B считалась 31 секунд, правка фото словами в Qwen-Image-Edit 90 секунд, видео из фото в Wan 2.2 5B в разрешении 720p 4,7 минуты, видео под голос в S2V 8,0 минуты. Пик занятой видеопамяти держался между 8,4 и 11,5 ГБ. К каждой схеме приложены файл, ссылки на модели с размерами и честный список того, где она ломается.
Как поставить workflow: файл, модели, одно дополнение
- Скачайте JSON и перетащите файл в окно ComfyUI или откройте через меню Workflow → Open. Наши файлы сохранены в формате API, в том самом виде, в каком мы отправляли их на карту. Интерфейс ComfyUI версии 1.49 открывает такой файл сам и раскладывает узлы по сетке.
- Разложите модели по папкам внутри ComfyUI/models: основная модель в diffusion_models, сжатая .gguf туда же или в unet, текстовый энкодер в text_encoders, VAE в vae, лоры в loras, кодировщик звука в audio_encoders, апскейлер в upscale_models, модель RIFE в frame_interpolation. FLUX.2 klein и Flux schnell в наших файлах грузятся узлом Load Checkpoint, поэтому их положите в checkpoints.
- Если узел красный, откройте Manager, нажмите Install Missing Custom Nodes и перезапустите ComfyUI. Из наших пяти схем дополнение нужно трём, и это одно и то же — ComfyUI-GGUF.
- Имена файлов у вас могут не совпасть с нашими. Тогда щёлкните по полю с именем модели в узле загрузки и выберите свой файл. Кодировщик klein у нас называется qwen_3_4b_klein.safetensors, а в репозитории Comfy-Org — qwen_3_4b.safetensors; VAE FLUX.2 у нас diffusion_pytorch_model.safetensors из репозитория BFL, у Comfy-Org тот же файл называется flux2-vae.safetensors.
- Поменяйте картинку в узле Load Image, текст промпта и нажмите Run.
Пять схем одной таблицей
Время — от нажатия Run до готового файла, с загрузкой моделей с диска. Пик памяти — сколько было занято на всей карте, включая рабочий стол Windows, около 2 ГБ. Объём — сколько вам качать моделей для схемы.
| Схема | Что делает | Время | Пик видеопамяти | Объём моделей | Дополнение |
|---|---|---|---|---|---|
| FLUX.2 klein 4B | картинка по тексту | 31 секунд | 9,3 ГБ | 16 ГБ | нет |
| Qwen-Image-Edit 2511 | правка фото словами | 90 секунд | 11,1 ГБ | 20 ГБ | ComfyUI-GGUF |
| Wan 2.2 5B, 720p | видео из фото, 81 кадр | 4,7 минуты | 11,5 ГБ | 18 ГБ | нет |
| Wan 2.2 14B, 480p | видео из фото, 81 кадр | 4,8 минуты | 8,7 ГБ | 30 ГБ | ComfyUI-GGUF |
| Wan 2.2 S2V | видео под голос | 8,0 минуты | 8,4 ГБ | 20 ГБ | ComfyUI-GGUF |
Картинка по тексту: FLUX.2 klein 4B, а не Flux schnell
Схема из ядра ComfyUI, дополнения не нужны: загрузчик модели, отдельно кодировщик текста Qwen3-4B и VAE FLUX.2, размер кадра, планировщик Flux2Scheduler на четыре шага, сэмплер и сохранение. Модель klein 4B дистиллирована на четыре шага и обходится без отрицательного промпта. Кадр 768×1344, это около мегапикселя, на котором модель и обучали.
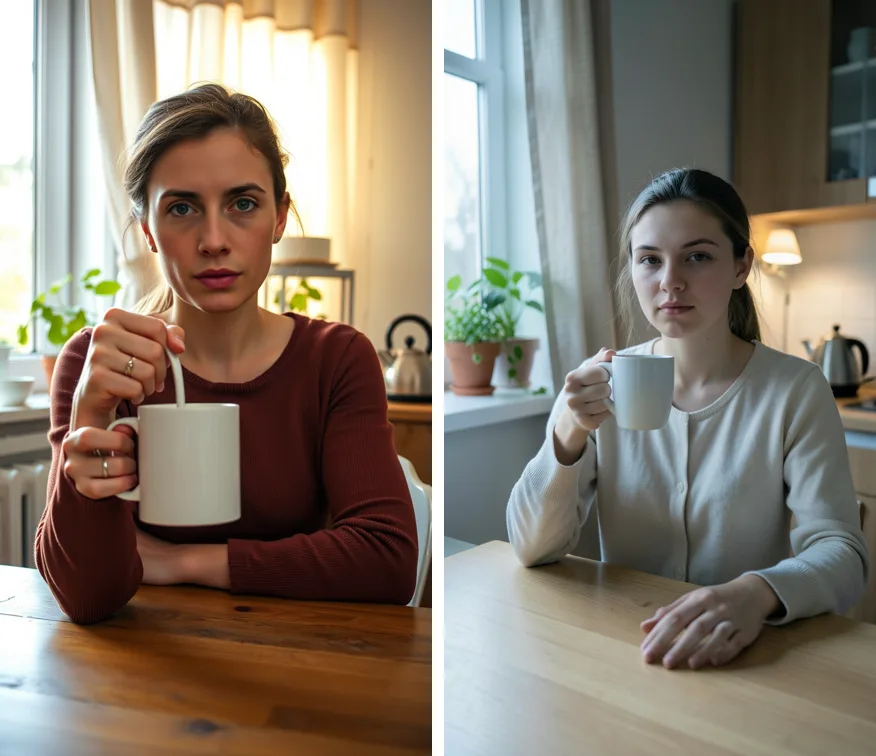
Портрет посчитался за 31 секунд, пик памяти 9,3 ГБ. Лицо вышло обычным, с живой кожей, без глянца. Помогли три вещи из нашего опыта. Средний план: голова занимает примерно пятую часть высоты кадра, а крупный портрет с нуля у klein тоже уходит в пластик. Свет: холодный дневной из окна слева и тёплая лампа за спиной, глаз читает это как съёмку. Руки описаны по отдельности: правая держит кружку за ручку, большой палец сверху, указательный продет в ручку, левая лежит на столе ладонью вниз.
Почему не schnell. Тот же промпт и тот же сид на Flux schnell считались 67 секунд, и руку модель сломала: ручка кружки прошла сквозь пальцы, вторая рука пропала. В первой нашей версии этой страницы schnell на кадре 576×1024 дал восковое лицо и пальцы без суставов, это и заставило переснять всё заново. Schnell оставляем для быстрых набросков, его схема лежит рядом.
Где ломается klein: на светосиле f/2 рука на переднем плане уходит в размытие, и пальцы читаются хуже. Надписи в кадре и мелкую графику модель не держит, их добавляют потом в редакторе.
Модели, всего около 16 ГБ:
- flux-2-klein-4b.safetensors, 7,8 ГБ
- qwen_3_4b.safetensors, 8,0 ГБ
- flux2-vae.safetensors, 0,3 ГБ
Скачать workflow flux2-klein-4b-kartinka.json
Схема на Flux schnell для сравнения — flux-schnell-kartinka.json, модель одним файлом на 17 ГБ.
Правка фото словами: Qwen-Image-Edit в сжатом GGUF
Схема берёт готовый снимок и меняет в нём то, что вы опишете, остальное оставляет. Модель Qwen-Image-Edit 2511 в полном виде больше, чем влезает в 12 ГБ, поэтому у нас она в сжатом формате GGUF уровня Q3_K_M на 10 ГБ. К ней подключена ускоряющая лора Lightning на восемь шагов, без неё шагов нужно в несколько раз больше.
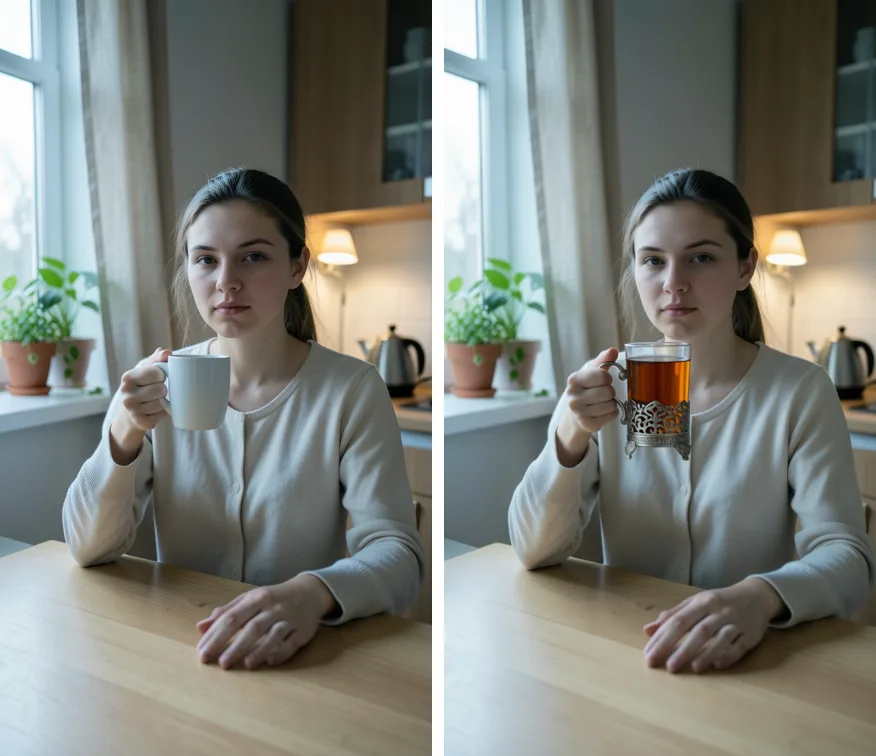
Мы попросили заменить кружку на стакан чая в подстаканнике и ничего больше не трогать. Ушло 90 секунд, пик памяти 11,1 ГБ. Подстаканник она держит за ручку, лицо, кофта, кухня и вторая рука на месте. Вам поможет такой порядок: назовите предмет вещью и размером, скажите, как рука его держит, и прямо перечислите, что оставить как есть.
Где ломается: когда в первой версии мы не описали руку, пальцы слились с металлом подстаканника. Мелкий дефект вроде лишней буквы или пятна вы быстрее уберёте ретушью: на команду «убери надписи» Qwen у нас однажды перерисовал весь кадр, сняв фон и цвет. И смотрите на результат своими глазами: сжатая модель с ускоряющей лорой бывает отдаёт полностью чёрный кадр со статусом «выполнено».
Модели, всего около 20 ГБ:
- qwen-image-edit-2511-Q3_K_M.gguf, 9,9 ГБ
- qwen_2.5_vl_7b_fp8_scaled.safetensors, 9,4 ГБ
- qwen_image_vae.safetensors, 0,2 ГБ
- Qwen-Image-Edit-2509-Lightning-8steps-V1.0-bf16.safetensors, 0,8 ГБ
Скачать workflow qwen-edit-pravka-foto.json
Те же задачи, что решает эта схема, — убрать лишнее, заменить надпись, состарить снимок — у нас есть готовыми промптами для Qwen. Они написаны под онлайн-версию, но модель та же, и текст переносится в узел промпта как есть.
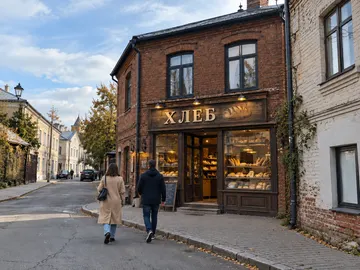
Промт: Убрать лишнее с фото: провода, люди, мусор
На загруженном снимке убери названный объект и дострой то, что за ним.

Что убрать: [ОБЪЕКТ: провода над улицей и мусорный бак справа]
Что остаётся нетронутым: [ГЛАВНОЕ: здание, вывеска, люди на переднем плане]

Место удалённого объекта достраивается по логике сцены, а не замыливается. Небо продолжается небом с тем же градиентом, кирпичная стена — тем же рисунком кладки со швами в тех же рядах, асфальт — той же фактурой и теми же трещинами по направлению.

Не копируй соседний участок целиком: повторяющийся кусок текстуры виден сразу, особенно на кирпиче и плитке. Рисунок должен продолжаться, а не дублироваться.

Границы удаления чистые: ореола, размытого пятна и следа контура на месте объекта быть не должно.

Тени и отражения объекта уходят вместе с ним. Убрали бак — с асфальта пропала и его тень, из витрины напротив исчезло отражение.

Геометрия сцены не меняется: линии крыш, окон и бордюров остаются прямыми и в прежних местах.

Остальной кадр без изменений: цвет, контраст, резкость и лица трогать нельзя.

Не добавляй: новые объекты на освободившееся место, размытие фона, виньетку и усиление резкости по краю правки.

Если объект перекрывал что-то важное — часть вывески, лицо, край стола, — скажи об этом прямо, вместо того чтобы дорисовывать по догадке. Придуманная часть вывески хуже честного «здесь не видно».

Проверка после правки: посмотри на место удаления при увеличении и на границу с соседними участками. Швов, смещения линий и разницы в зерне быть не должно.
Видео из фото: Wan 2.2 5B в родных 720p
Младшая модель Wan 2.2 одна, без деления на половины, и обходится ядром ComfyUI: файл fp16 на 10 ГБ, двадцать шагов. Главное у неё — разрешение. Модель рассчитана на 720p, и мы считаем её в 704×1280. В первой версии страницы мы гоняли её в 480×832, и на третьем кадре у героини перекосило лицо.
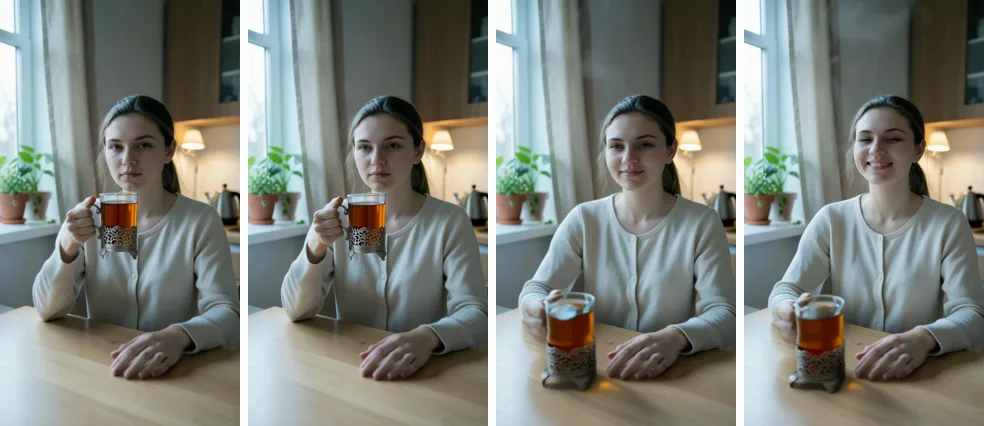
Правленый кадр ожил за 4,7 минуты, пик памяти 11,5 ГБ. Героиня держит стакан у груди, опускает его на стол и улыбается, лицо держится до конца. 81 кадр при родных для 5B 24 кадрах в секунду — это 3,4 секунды, и скорость движения естественная. Описывайте движение на месте, а не через весь кадр, и добавьте фразу «камера неподвижна»: у нас с ней дрожание ниже. Слово static в негативный промпт не ставьте, оно стоило нам брака.
Где ломается: глотка, который просил промпт, 5B не сделала — три шага подряд, поднять, отпить и поставить, она упростила до одного. Просите одно действие на ролик: только глоток или только «ставит стакан и улыбается». И когда стакан стоит на столе, у подстаканника пропадает ручка; если предмет важен до последнего кадра, держите его в руке.
Модели, всего около 18 ГБ:
- wan2.2_ti2v_5B_fp16.safetensors, 10,0 ГБ
- umt5_xxl_fp8_e4m3fn_scaled.safetensors, 6,7 ГБ
- wan2.2_vae.safetensors, 1,4 ГБ
Скачать workflow wan22-5b-720p-video-iz-foto.json · ролик mp4
Та же задача на Wan 2.2 14B
Старшая модель Wan 2.2 состоит из двух половин: первая отвечает за движение, вторая за детали. В схеме это два загрузчика GGUF уровня Q5_K_M по 10,8 ГБ, два сэмплера на три и пять шагов и ускоряющие лоры lightx2v. На 12 ГБ мы считаем её в 480×832: тот же кадр ожил за 4,8 минуты, пик памяти 8,7 ГБ. Это столько же, сколько у 5B в 720p, а картинка мягче. Зато движение 14B выполнила как просили: подняла стакан, отпила и улыбнулась. Схема пригодится, если вам важнее точность движения, чем чёткость: родная частота 14B — 16 кадров в секунду, поставьте её в узле Save WEBM, и ролик станет пять секунд.
Модели, всего около 30 ГБ:
- Wan2.2-I2V-A14B-HighNoise-Q5_K_M.gguf, 10,8 ГБ
- Wan2.2-I2V-A14B-LowNoise-Q5_K_M.gguf, 10,8 ГБ
- umt5_xxl_fp8_e4m3fn_scaled.safetensors, 6,7 ГБ
- wan_2.1_vae.safetensors, 0,2 ГБ
- wan2.2_i2v_A14b_high_noise_lora_rank64_lightx2v_4step_1022.safetensors, 0,6 ГБ
- wan2.2_i2v_A14b_low_noise_lora_rank64_lightx2v_4step_1022.safetensors, 0,7 ГБ
Скачать workflow wan22-14b-video-iz-foto.json
Что ещё мы поняли про видео на домашней карте — сколько стоит секунда, почему клип не растягивается и какие слова ломают кадр, — разобрано в статье «Локальные нейросети для видео», а целый мультфильм из таких фрагментов — в разборе «Как сделать мультфильм нейросетью».
Видео под голос: Wan 2.2 S2V
Эта схема ведёт движение лица по звуку: на вход портрет и дорожка голоса, на выходе человек, который её произносит. Модель S2V на 14 миллиардов параметров у нас в сжатом GGUF уровня Q3_K_M на 11,4 ГБ, звук разбирает английский wav2vec2 large. После счёта схема поднимает ролик до 1080×1920 апскейлером 4x-UltraSharp и дорисовывает промежуточные кадры через RIFE до 48 в секунду.
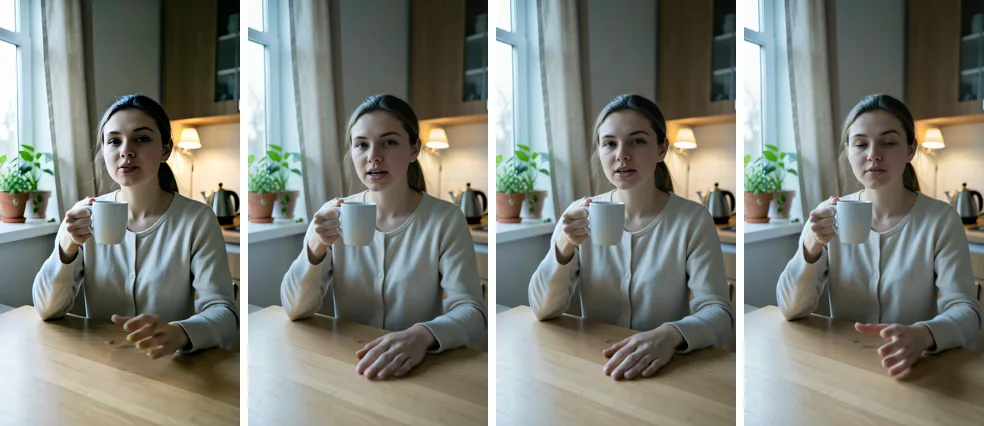
Портрет klein и фраза на 4,7 секунды посчитались за 8,0 минуты, пик памяти 8,4 ГБ. Рот двигается, мимика живая, лицо держится, а свободной рукой героиня жестикулирует в такт речи. Чтобы губы попадали в слова, в промпт мы пишем, что человек произносит слова дорожки вслух и губы движутся в такт каждому слову.
Где ломается: звука в готовом файле нет, узел Save WEBM сохраняет только картинку. Голос вы подкладываете после, например ffmpeg одной командой: ffmpeg -i video.webm -i golos.wav -c:v libx264 -c:a aac -shortest itog.mp4.
Оживлять так можно своё фото или фото человека, который на это согласился. Чужое лицо, которое говорит чужие слова, — это подделка, и отвечать за неё будет автор. Наша героиня вымышленная, её нарисовала схема FLUX.2 klein выше, а голос синтетический.
Модели, всего около 20 ГБ:
- Wan2.2-S2V-14B-Q3_K_M.gguf, 11,4 ГБ
- wav2vec2_large_english_fp16.safetensors, 0,6 ГБ
- umt5_xxl_fp8_e4m3fn_scaled.safetensors, 6,7 ГБ
- wan_2.1_vae.safetensors, 0,2 ГБ
- wan2.2_i2v_A14b_low_noise_lora_rank64_lightx2v_4step_1022.safetensors, 0,7 ГБ
- 4x-UltraSharp.pth, меньше 0,1 ГБ
- rife_v4.26_heavy.safetensors, меньше 0,1 ГБ
Скачать workflow wan22-s2v-video-pod-golos.json · ролик mp4
Если workflow не запускается
- Красный узел — у вас нет дополнения. Manager → Install Missing Custom Nodes, потом перезапуск.
- Ошибка «Value not in list» у загрузчика — у вас нет файла с таким именем. Выберите свой файл в поле узла.
- Вашей карте не хватает памяти, out of memory, — возьмите сжатие посильнее, Q4 или Q3 вместо Q5, уменьшите разрешение или число кадров.
- ComfyUI закрылся без ошибки посреди задания — скорее всего, кончилась оперативная память: в ней остаются модели прошлых запусков. У нас так упал запуск klein после нескольких видео. Выгрузите модели кнопкой Unload Models в Manager или перезапустите ComfyUI, и закройте другие тяжёлые программы.
- Чёрный кадр при статусе «выполнено» — сжатая модель и ускоряющая лора не сошлись. Смените уровень сжатия или число шагов и смотрите на результат глазами.
Нет видеокарты или карта AMD
Все замеры на этой странице сделаны на NVIDIA. ComfyUI запускается и на AMD: в Linux через ROCm, для Windows есть неофициальные сборки. Сжатые модели и видео на AMD мы не проверяли и обещать ничего не будем.
Если своей карты у вас нет, путей два. Облако с почасовой оплатой подойдёт вам, чтобы попробовать схему пару вечеров. Если вы генерируете каждый день или держите ComfyUI с моделями на сотню гигабайт, удобнее сервер с видеокартой целиком под вас: ваши модели лежат на его диске и не качаются заново. Такие серверы есть у is*hosting — выделенные с NVIDIA L4 на 24 ГБ и Tesla T4 на 16 ГБ: сервер с видеокартой у is*hosting (реклама). L4 того же поколения, что наша карта, но с вдвое большей памятью; T4 постарше и считает медленнее, зато памяти в ней больше, чем у нас. Пик всех пяти схем у нас не выходил за 11,5 ГБ, на 24 ГБ они помещаются с запасом.
FAQ
Как открыть JSON workflow в ComfyUI?
Перетащите файл мышью в окно вашего ComfyUI или откройте его через меню Workflow → Open. Наши файлы в формате API, интерфейс сам расставит узлы. После этого вам останется выбрать свои файлы моделей в узлах загрузки и заменить картинку в Load Image.
Хватит ли 8 ГБ видеопамяти?
Мы мерили на 12 ГБ: пик был от 8,4 до 11,5 ГБ на всей карте. ComfyUI умеет выгружать модели в оперативную память, поэтому если у вас 8 ГБ, картинка и правка фото, скорее всего, пойдут, только медленнее, а для видео вам лучше взять сжатие Q3 и меньше кадров. На 8 ГБ мы сами, правда, не проверяли.
Что выбрать: Wan 2.2 5B или 14B?
На 12 ГБ у нас 5B в 720p и 14B в 480p считались одинаково, около пяти минут на ролик. Картинка у 5B чётче, и она обходится ядром ComfyUI, но сложное движение упрощает: глоток она пропустила, а 14B сделала. Нужна чёткость и простое движение — 5B, только в 720p, в 480p у неё перекашивает лицо. Нужно точное действие — 14B.
Можно ли оживить фото реального человека?
Своё фото или фото человека, который согласился, — да. Чужое лицо, которое говорит чужие слова, — нет: это подделка. На этой странице героиня вымышленная, её нарисовала схема FLUX.2 klein, а голос синтетический.
Где брать модели и можно ли использовать результат в работе?
Все ссылки ведут на официальные репозитории на Hugging Face: Comfy-Org, QuantStack, unsloth, lightx2v и авторов моделей. У FLUX.2 klein 4B, Flux schnell, Qwen-Image и Wan 2.2 лицензия Apache 2.0, она разрешает коммерческое использование. У ускоряющих лор и апскейлера условия смотрите на странице каждого файла.